声明
本文由 🤖AI 协作完成.
最近在给 Agent 搭文档解析流水线时,试了 SoMark 团队新开源的 OXR(Optical Everything Recognition)。它在三大基准上都拿了第一,但参数量只有 1.3B、权重 3GB 出头,小机器也能跑,遂记录部署与实测过程。
1. OXR 是什么
OXR 是一个从零预训练(Pretrained from Scratch)的文档解析模型,可将 PDF 和文档图片解析为 Agent-Friendly 的 Markdown / JSON,同时输出版面分析结果。
几个亮点:
- RSI 训练范式:后训练阶段首次引入面向文档解析的递归自我改进(Recursion Self Improvement)训练,在 OmniDocBench、olmOCR-Bench、DocParsingBench 三大基准上精度均位列第一,解析速度也达到业内领先水平
- 可插拔版面分析:版面分析模块首次被设计为独立、可插拔的模块。用户可以用自有模型替换内置的版面分析模型,以最小成本适配自己的文档结构要求
2. 构建与部署
2.1 下载模型
权重约 3.07GB,用 modelscope 拉取(国内网络环境友好):
1 | cd ~/llm |
2.2 构建镜像
1 | cd ~/workspace/github |
Note
docker build 时通过 VLLM_IMAGE 参数把基础 vLLM 镜像替换为国内镜像源(daocloud),避免拉取超时。digest 用官方原版,保证与官方镜像完全一致。
2.3 启动服务
1 | docker run --rm --gpus all --name oxr -d --ipc=host \ |
Note
GPU 显存紧张时,可通过 VLLM_GPU_MEMORY_UTILIZATION 控制 vLLM 占用的显存比例。
3. 测试验证
OXR 提供三种访问方式,假定部署服务器局域网域名为 spark-264d.local:
3.1 可视化 Demo
浏览器打开 http://spark-264d.local:8006/demo,上传 PDF 或图片,可以对照查看原文件、Markdown 预览与源码、版面框与阅读顺序,并能直接下载 Markdown。
Note
Demo 使用临时文件缓存,默认有效期 1 小时(处理期间会自动续期)。缓存过期或被清理后无法继续访问,看完记得及时下载结果。
3.2 HTTP 接口
1 | curl --fail-with-body http://spark-264d.local:8006/v1/parse/sync \ |
3.3 CLI / SDK
SoMark 为解析业务封装了完善的自有服务 CLI & SDK(Python 和 JS 双语言),OXR 项目兼容其文档解析接口,只需替换 baseURL 即可无缝替换:
1 | pip install somark |
详细文档见 docs.somark.ai。
4. 实测效果
在 DGX Spark 上实测了几类典型文档:
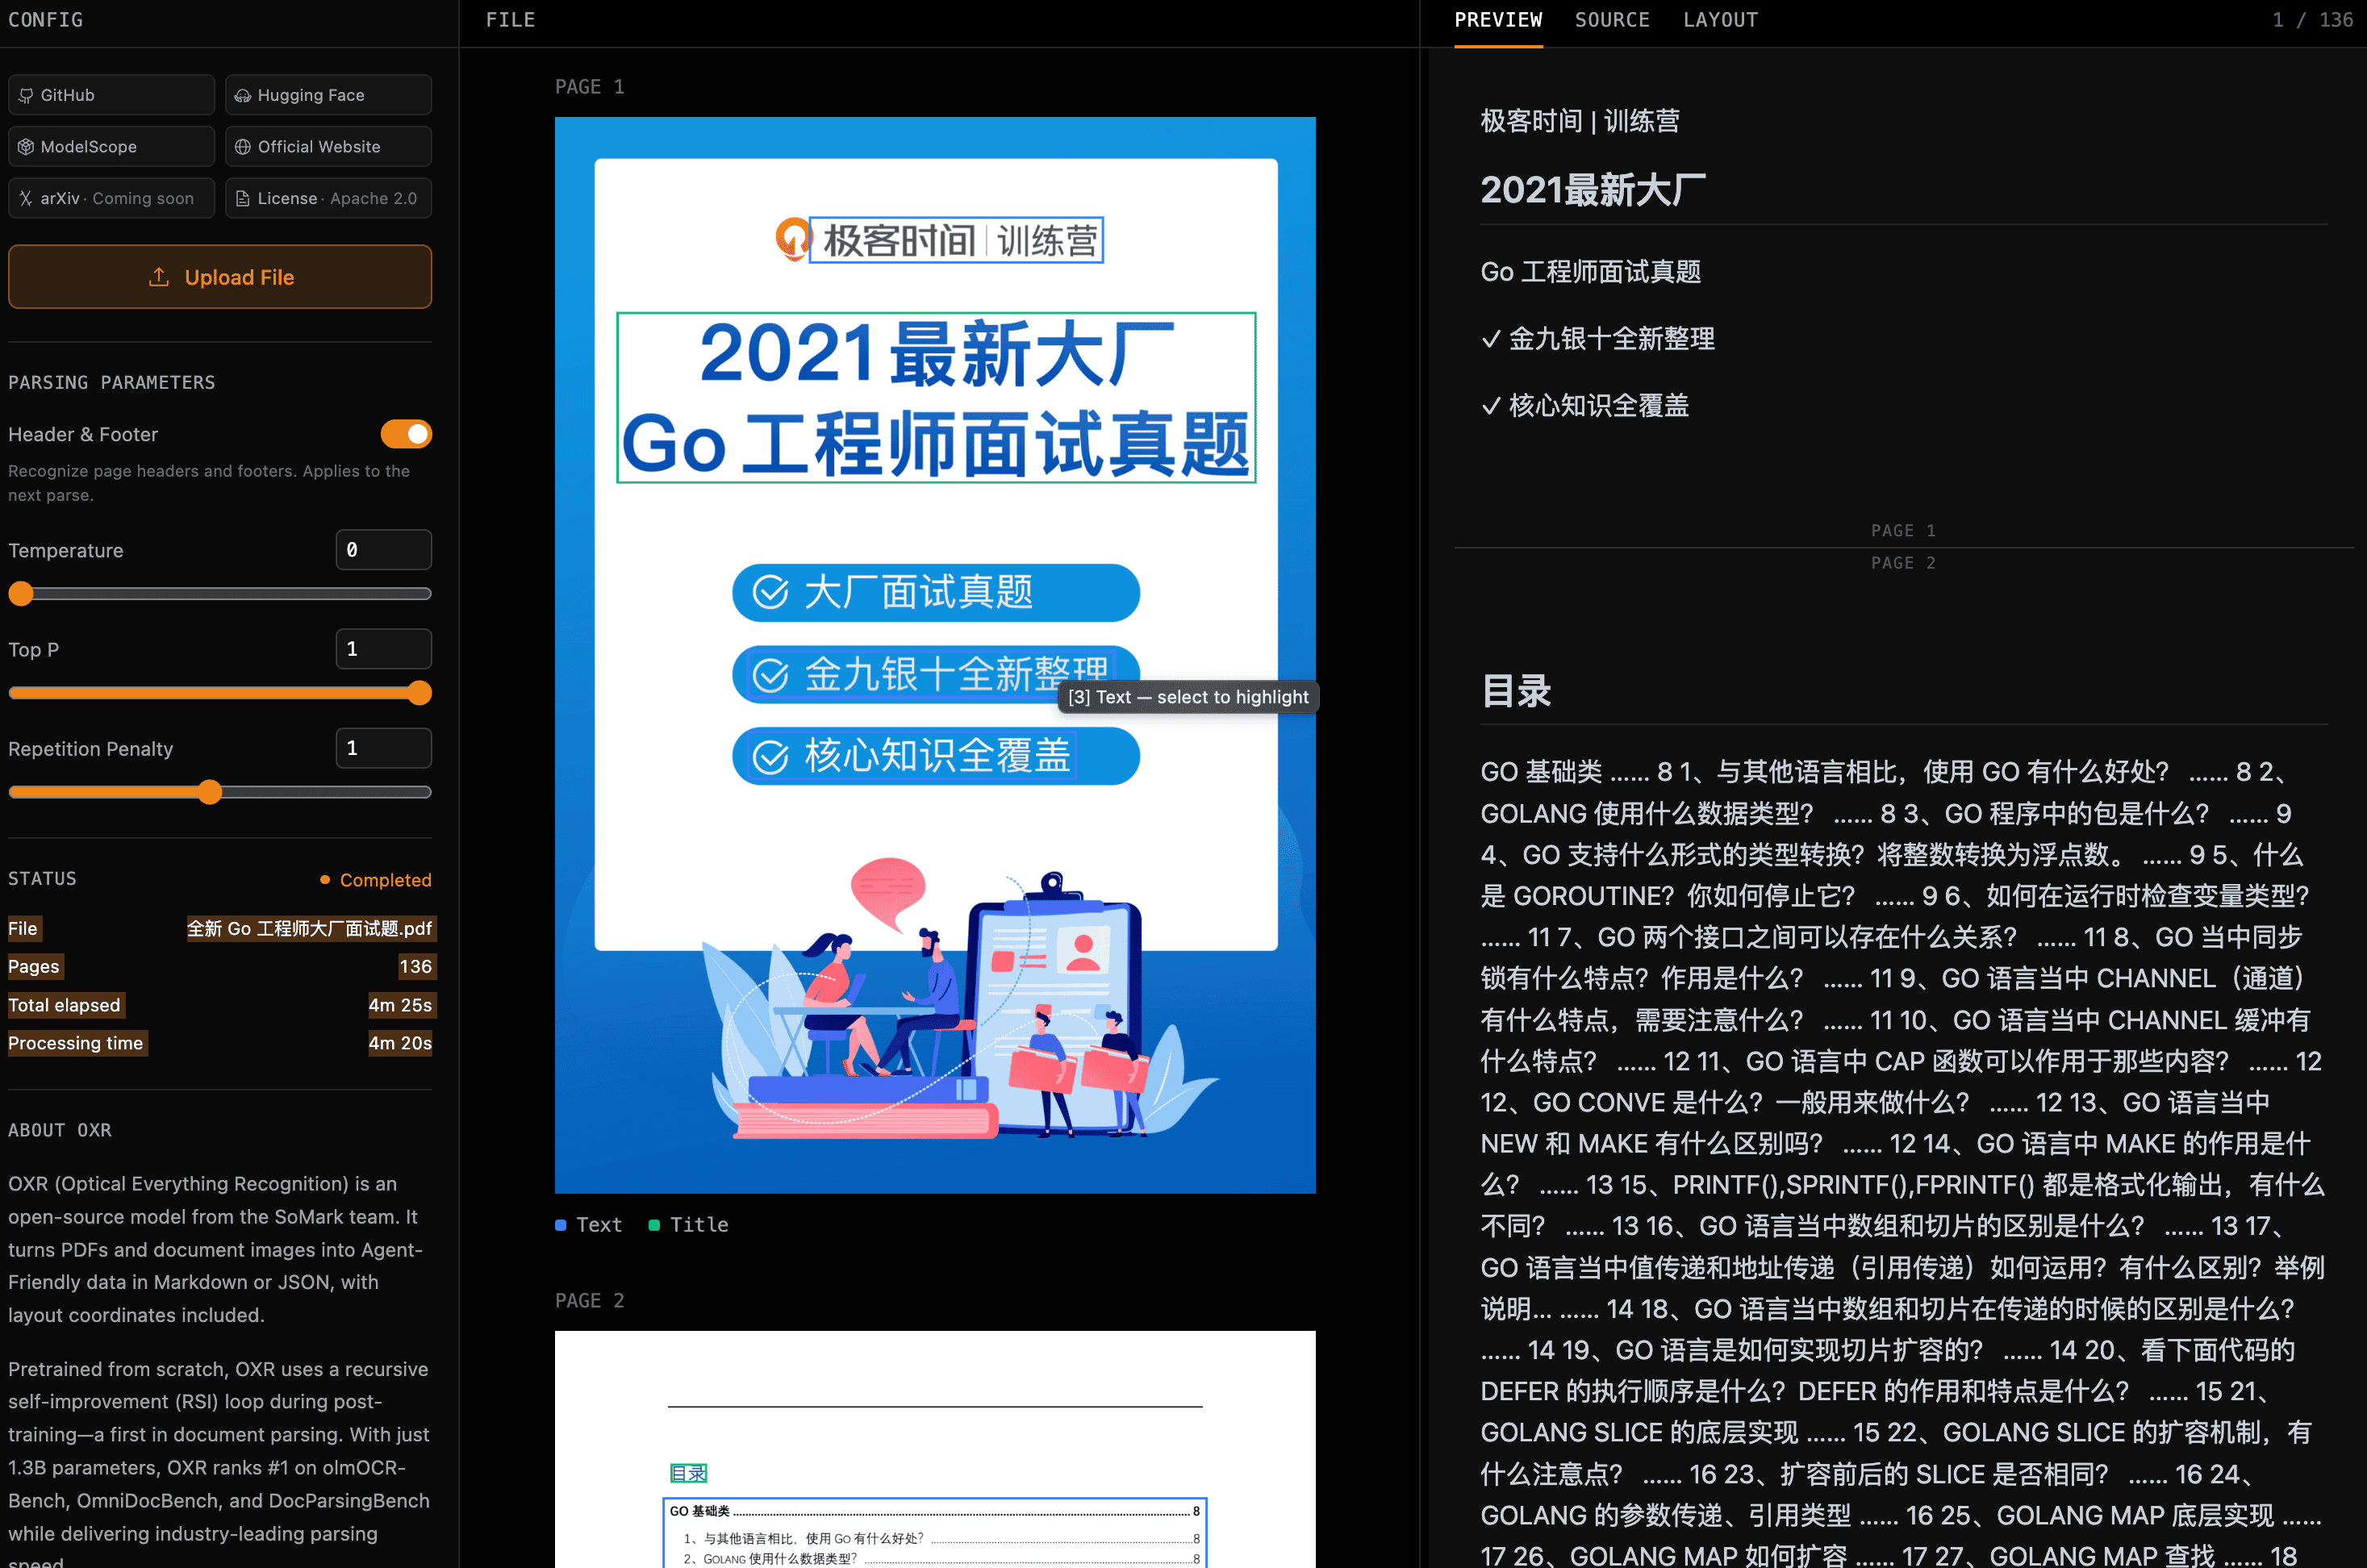
长文档解析:136 页 PDF 用时 4m 20s,全程无需干预:
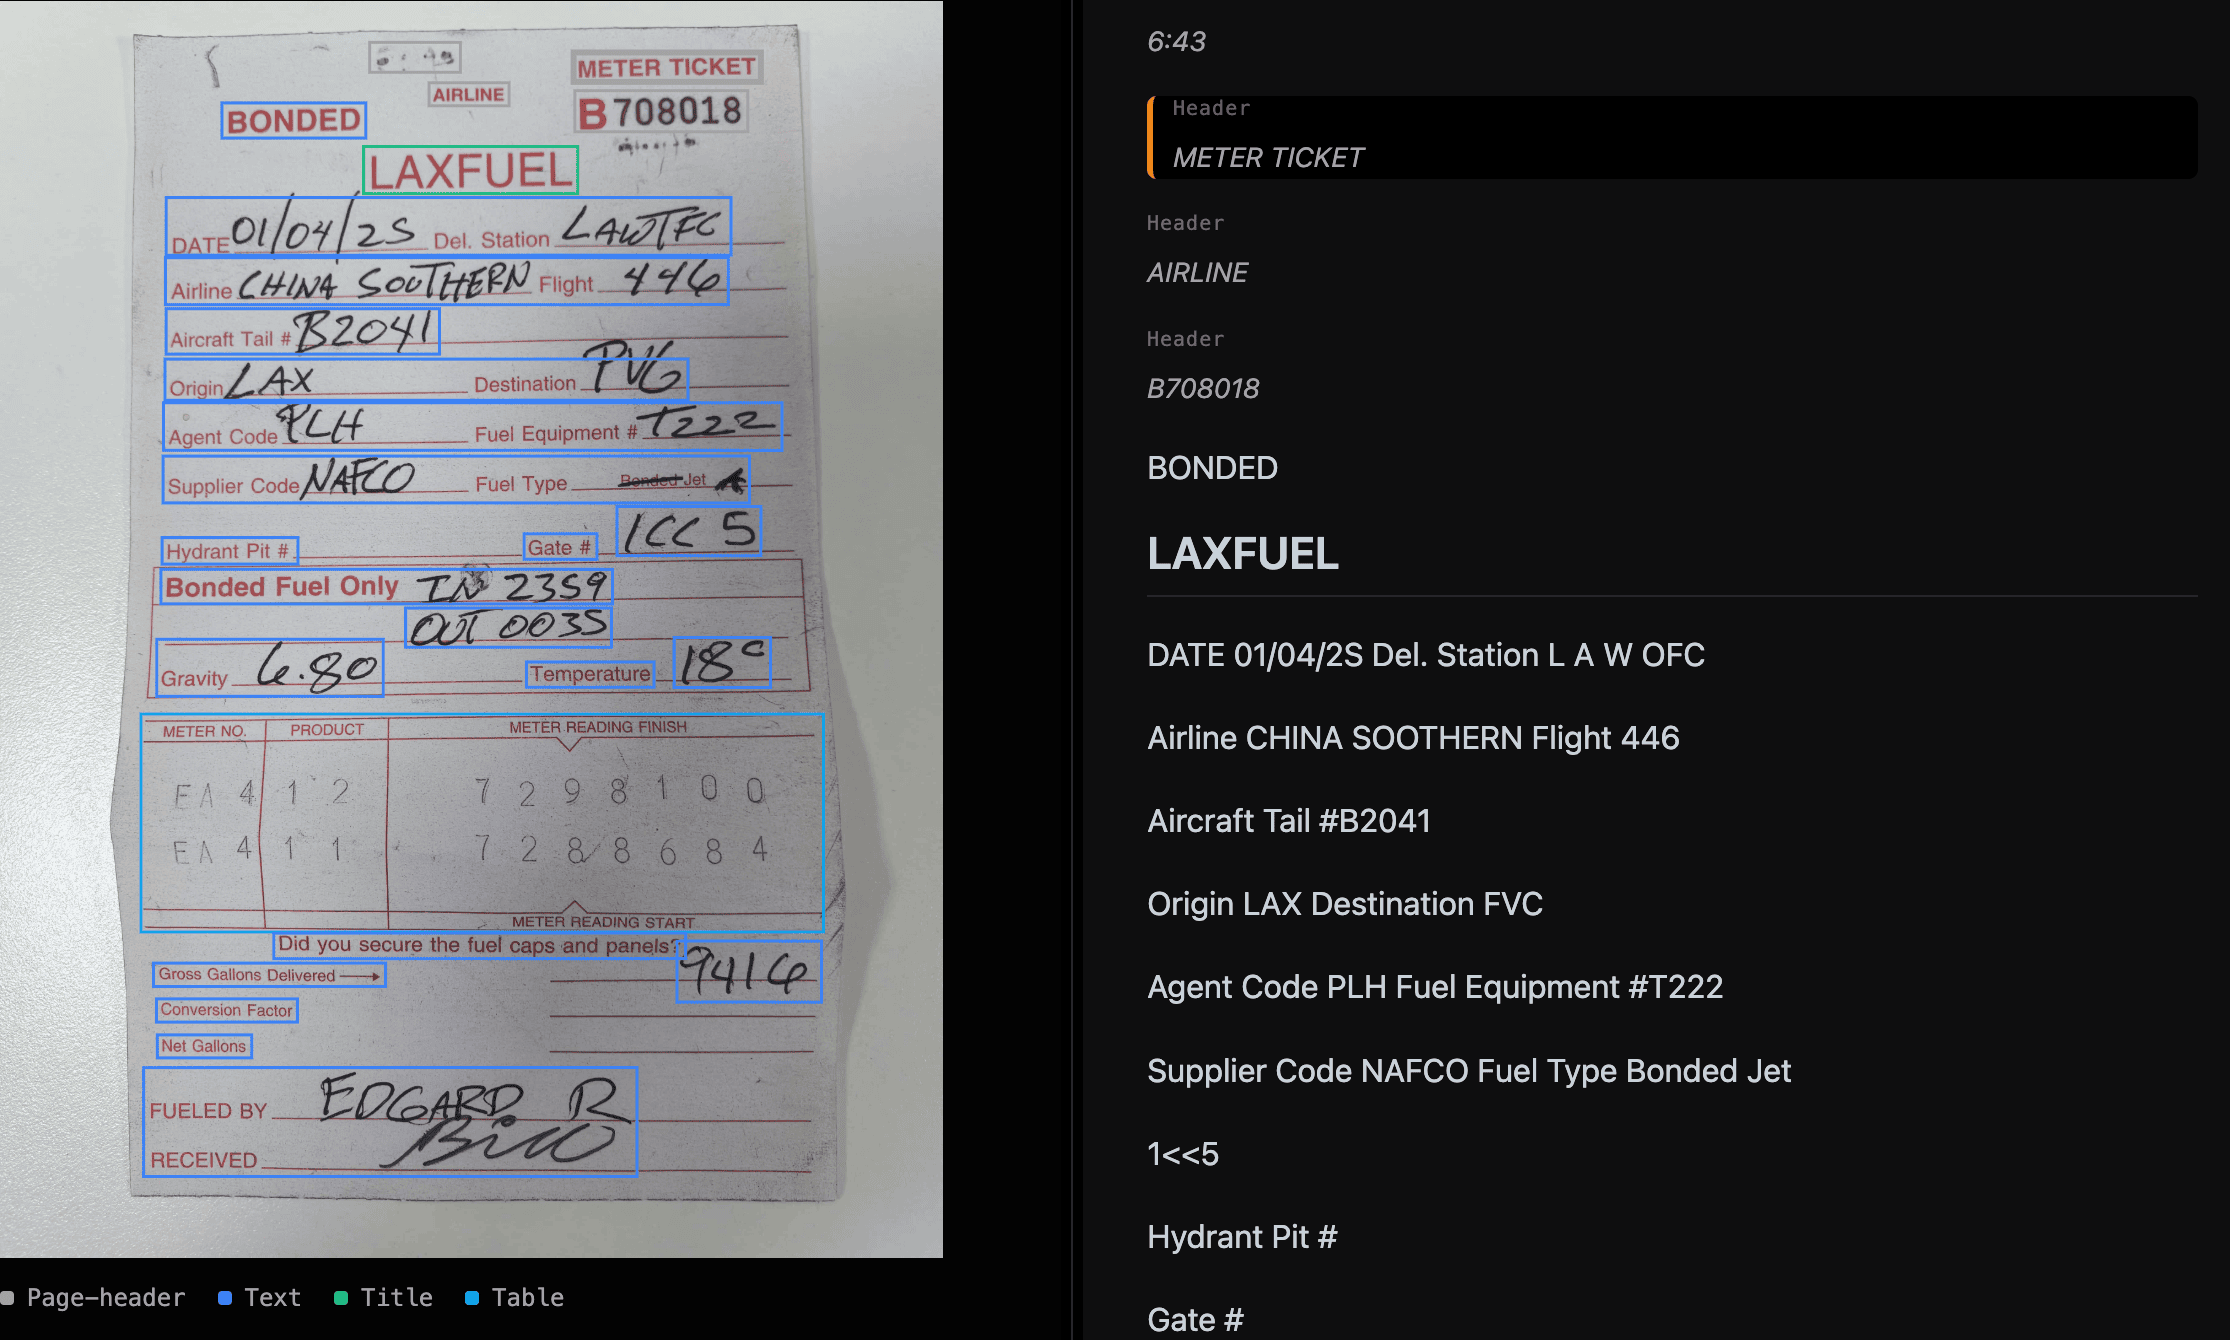
加油单等表格票据:
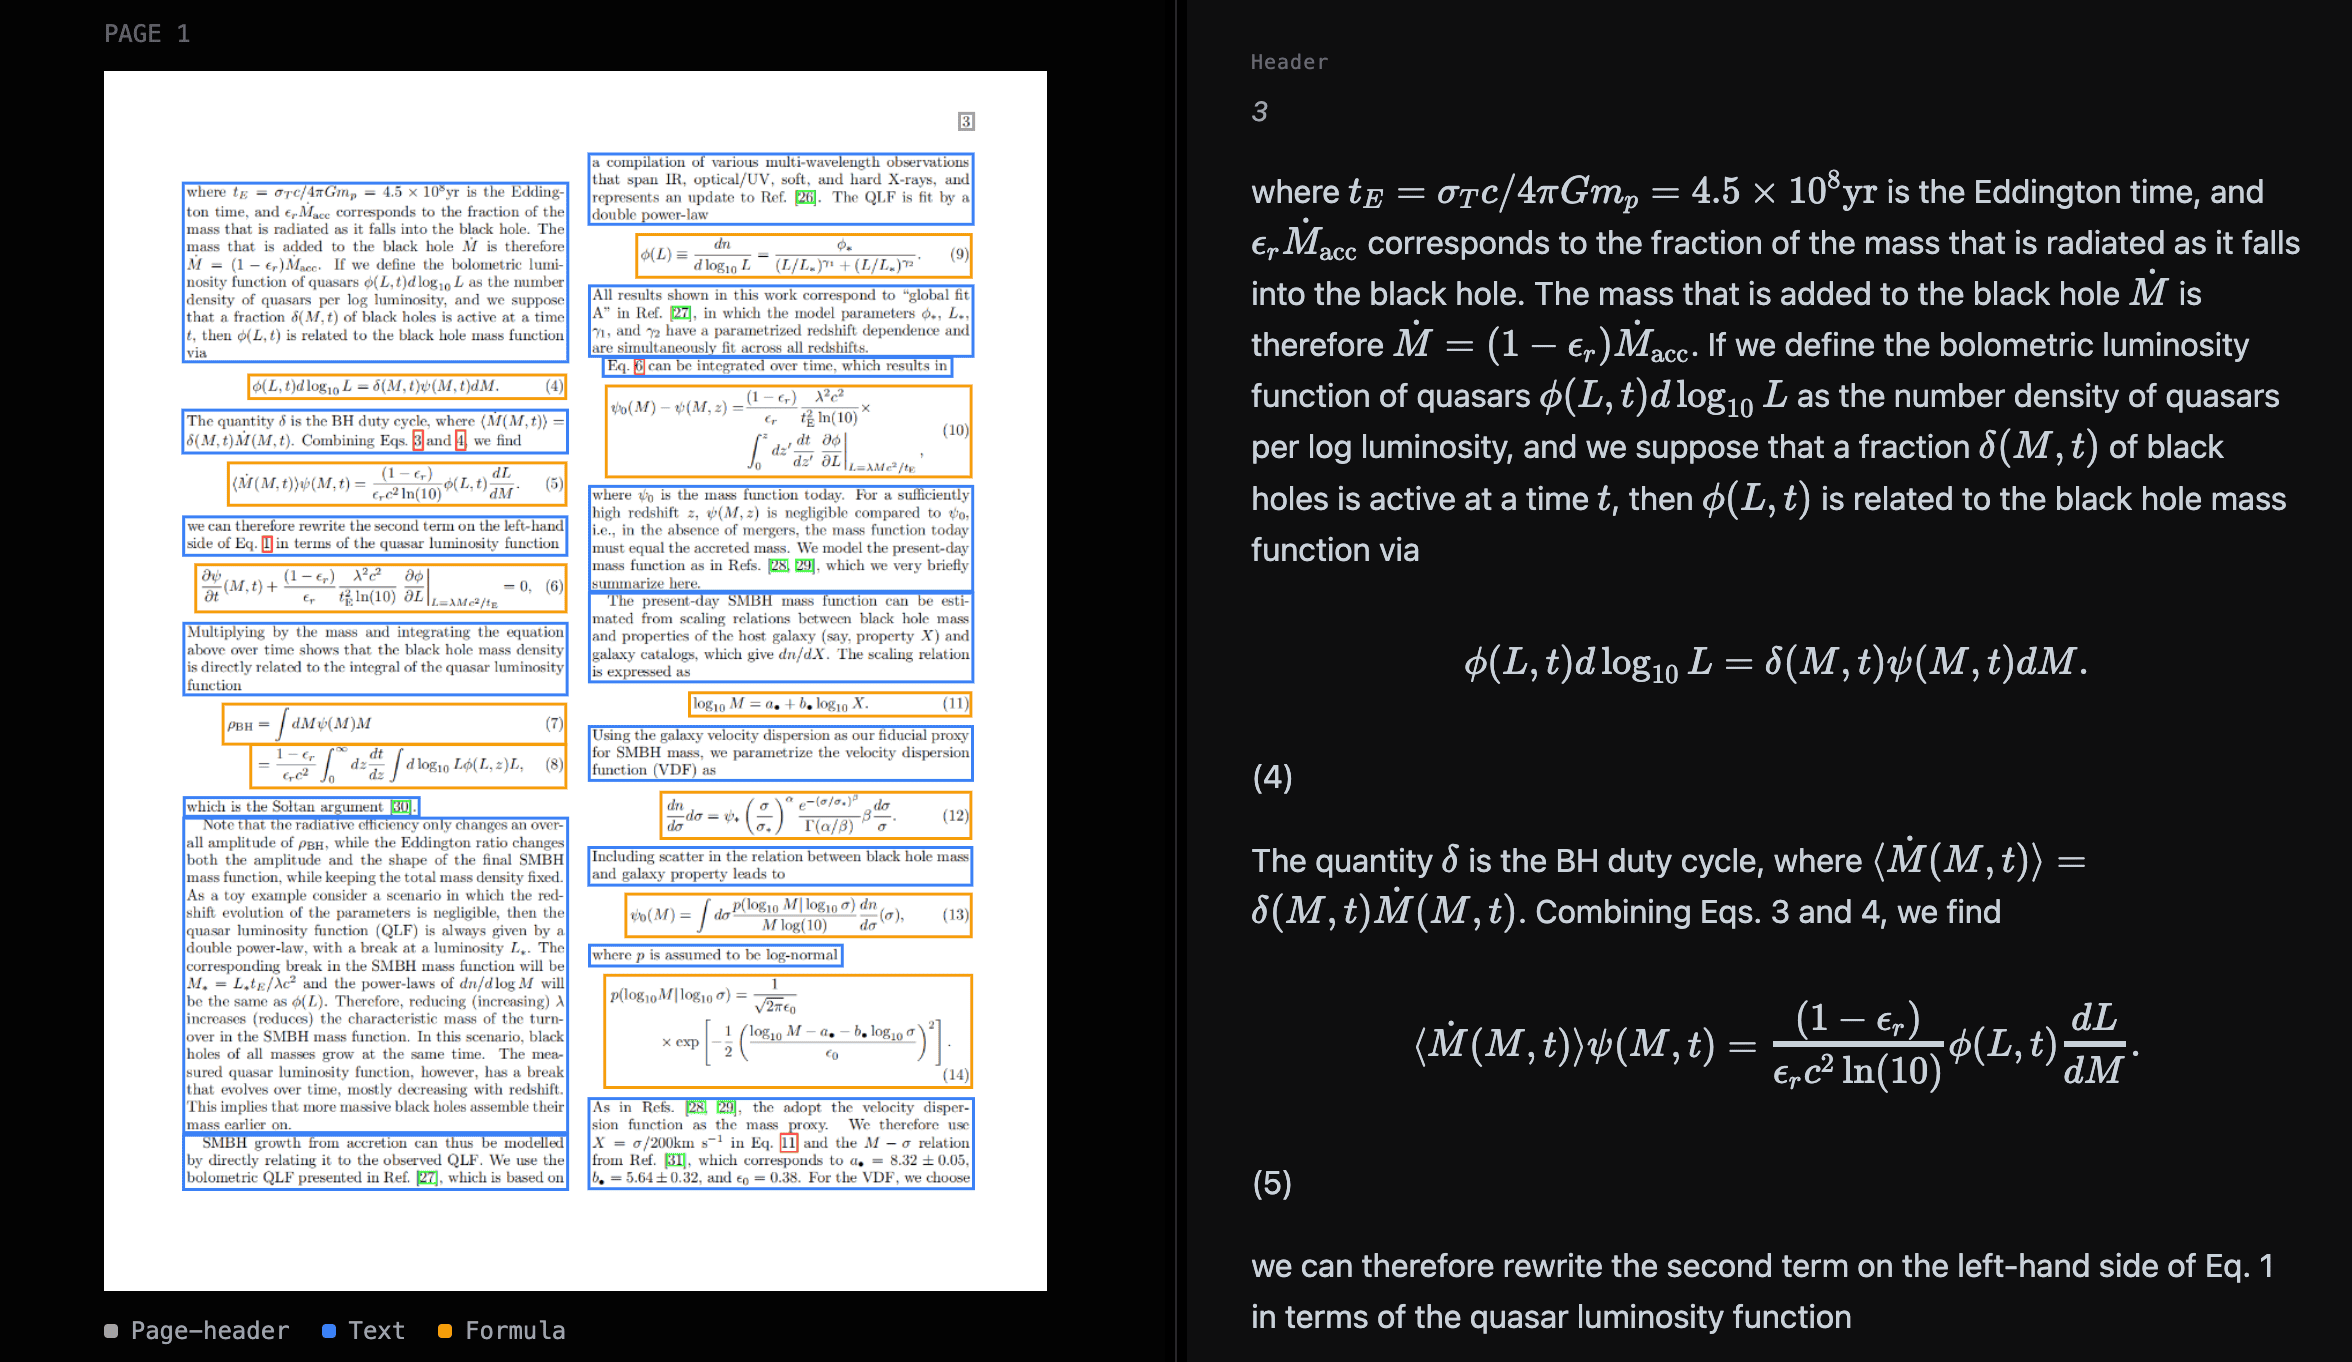
数学公式:
5. 总结
和主力在用的 MinerU 对比:
- 速度:OXR 快很多,136 页 4 分多钟扫完
- 质量:与 MinerU 相当,质量很高
- 中间产物:结构简单明确,就四个主要字段 ——
bbox/type/format/content,Agent 消费很省心